Robots.txt : le guide pratique, robots des IA compris
Ce que robots.txt fait et ne fait pas, les règles de Google, un exemple propre, et comment traiter GPTBot, OAI-SearchBot, PerplexityBot et Google-Extended.
Le fichier robots.txt tient en quelques lignes, à la racine de votre site, et il peut faire disparaître un site entier de Google en une ligne mal écrite. C'est aussi lui qui décide si ChatGPT, Perplexity ou Gemini peuvent lire vos pages. Voici ce qu'il fait vraiment, ce qu'il ne fait pas, et comment l'écrire en 2026.
À quoi sert robots.txt
Google le résume dans sa présentation du fichier : robots.txt indique aux robots d'exploration quelles URL ils peuvent consulter. Il sert surtout à éviter de surcharger votre serveur et à épargner aux robots des pages inutiles (recherche interne, filtres, paniers).
Ce qu'il ne fait pas, et c'est l'erreur la plus fréquente : il n'empêche pas une page d'apparaître dans Google. Une page bloquée peut quand même être indexée si d'autres sites pointent vers elle ; elle apparaît alors sans description. Pour retirer une page des résultats, il faut une balise noindex (et laisser la page explorable pour que Google la voie) ou une protection par mot de passe.
Autre limite : les robots sérieux respectent robots.txt, les autres non. Ce n'est pas un outil de sécurité : n'y listez pas les adresses de pages sensibles, vous les signaleriez.
Les règles de base
D'après les spécifications de Google :
- Le fichier se trouve à la racine :
https://votresite.fr/robots.txt. Un sous-domaine a son propre fichier. - Google comprend quatre instructions :
User-agent,Allow,DisallowetSitemap.Crawl-delayest ignoré par Google. - Les chemins sont sensibles à la casse :
/Admin/et/admin/sont deux règles différentes. - Quand plusieurs règles s'appliquent, la plus précise (le chemin le plus long) l'emporte ; à égalité, c'est la moins restrictive.
- Un robot suit le groupe
User-agentqui le désigne le plus précisément, et ignore alors le groupe*. - Google lit les 500 premiers Kio et garde le fichier en cache jusqu'à 24 heures.
- Si le fichier répond par une erreur 4xx, Google considère qu'il n'y a aucune restriction. S'il répond par une erreur 5xx, Google suspend l'exploration du site : un serveur qui plante sur robots.txt peut bloquer tout votre référencement.
Un exemple propre
User-agent: *
Disallow: /recherche/
Disallow: /panier/
Disallow: /*?filtre=

Sitemap: https://votresite.fr/sitemap.xml
Pour un WordPress, inutile de bloquer /wp-content/ ou /wp-includes/ : Google a besoin des fichiers CSS et JavaScript pour comprendre la mise en page. Bloquer ces ressources peut nuire à l'analyse de vos pages.
Les robots des IA
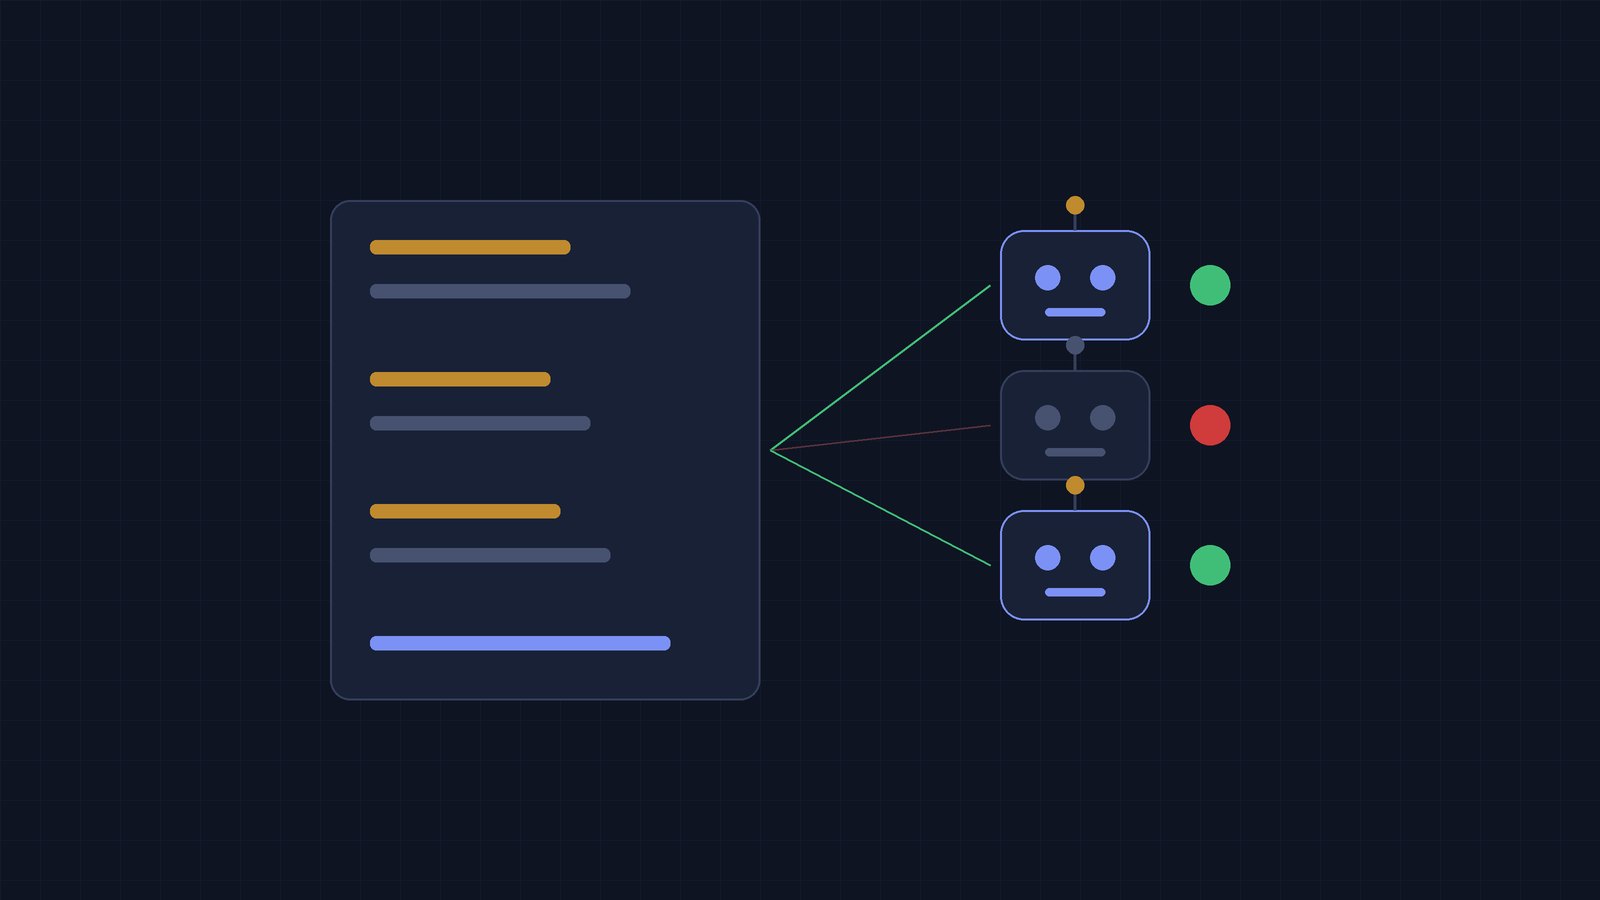
C'est là que robots.txt a pris une nouvelle importance. Chaque éditeur d'IA a plusieurs robots, avec des rôles différents. Les bloquer en bloc, comme le proposent certaines extensions, peut vous faire disparaître des réponses des assistants sans que vous le sachiez.
| Robot | Éditeur | Rôle | Effet d'un blocage |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Recherche de ChatGPT | Plus de citation dans les réponses avec recherche |
| GPTBot | OpenAI | Entraînement des modèles | Contenu exclu de l'entraînement, pas de la recherche |
| PerplexityBot | Perplexity | Index de Perplexity | Texte des pages non indexé par Perplexity |
| Google-Extended | Usage pour Gemini (entraînement et ancrage) | Aucun effet sur Google Search ni sur le classement | |
| Bingbot | Microsoft | Bing et Copilot | Disparition de Bing et de Copilot |
Google-Extended mérite une précision : ce n'est pas un robot à part, mais un nom à utiliser dans robots.txt. Selon la documentation de Google, il contrôle l'usage de vos contenus pour entraîner Gemini et pour l'ancrage dans les applis Gemini et Vertex AI, et n'a aucun effet sur votre présence dans Google Search ni sur votre classement. Les Aperçus IA de Google, eux, reposent sur Googlebot comme le reste de la recherche.
Une configuration courante pour être visible dans les IA sans fournir de données d'entraînement :
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /recherche/

Sitemap: https://votresite.fr/sitemap.xml
Dans cet exemple, OAI-SearchBot, PerplexityBot, Googlebot et Bingbot suivent le groupe * et peuvent explorer le site. À vous de décider si vous acceptez l'entraînement : bloquer GPTBot ne fait pas disparaître de ChatGPT aujourd'hui, mais les futurs modèles connaîtront moins votre marque.
Les pièges
- Le
Disallow: /de la préproduction resté en place après la mise en ligne. Classique, et catastrophique. - Le pare-feu qui bloque ce que robots.txt autorise : extensions de sécurité, protections anti-robots de l'hébergeur ou de Cloudflare peuvent refuser les robots d'IA indépendamment du fichier. Vérifiez les deux.
- Bloquer une page pour la désindexer : Google ne verra jamais la balise noindex. Il faut au contraire la laisser explorable.
- Bloquer des URL à paramètres en masse sans vérifier que des pages importantes n'en ont pas.
Pour tester, Search Console propose un rapport robots.txt (dans les paramètres) qui montre la version lue par Google et ses éventuelles erreurs. La vérification des accès des robots d'IA fait partie de chaque audit GEO ; pour la suite, lisez Comment apparaître dans les réponses des IA.
Nicolas Framery est consultant SEO et GEO à Aix-en-Provence, fondateur de Galaxy SEO et d'Etalo. Son parcours.